בכתבה הזו
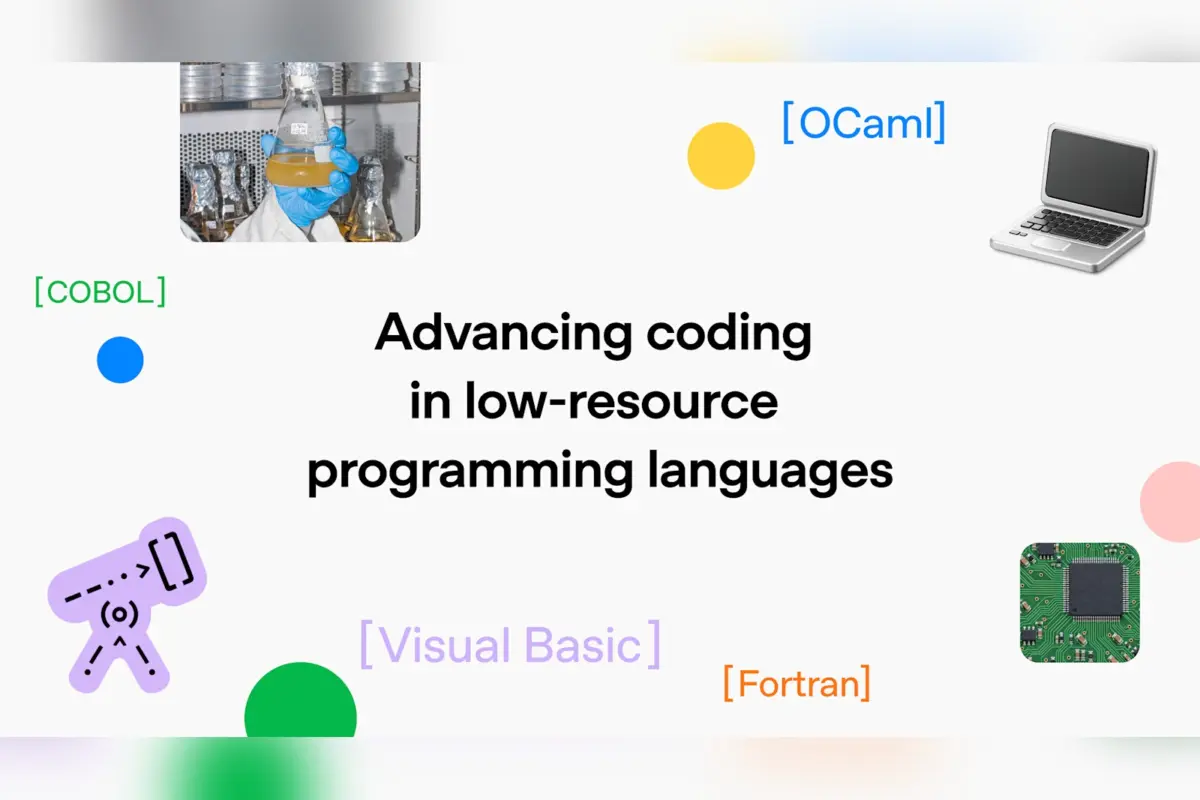
OpenAI פרסמה נתונים על שיפור משמעותי ביכולת של המודלים החדשים שלה לכתוב ולהמיר תוכנה בשפות תכנות ותיקות ופחות נפוצות, כמו COBOL, Fortran ו-Visual Basic. לדברי החברה, ההתקדמות נמדדה בשני מבחנים שפיתחה בעצמה. התוצאות הן של OpenAI ולא אומתו באופן עצמאי.
למה דווקא השפות האלה
לשפות כאלה יש הרבה פחות קוד ותיעוד זמינים ללמידה מאשר ל-Python או JavaScript, ולכן מודלים התקשו בהן. אבל הן מחזיקות תשתיות קריטיות. לפי OpenAI, COBOL פועלת ביותר מ-40% ממערכות הבנקאות המקוונת, ב-80% מעסקאות כרטיסי האשראי הפיזיות וב-95% מהעסקאות בכספומטים. Fortran משמשת לחיזוי מזג אוויר ולניתוחי בטיחות של כורים גרעיניים.
התחזוקה קשה: התיעוד חלקי, המפתחים המקוריים עזבו, וחוקים עסקיים חשובים קיימים רק בתוך הקוד. החברה אומרת שהעבודה הונחתה על ידי משוב ממפתחים ולקוחות ארגוניים.
המבחן הראשון: בניית מנוע מסד נתונים
MultiLangBench מבקש מהמודל לבנות מאפס מנוע מסד נתונים תואם SQLite ב-20 שפות תכנות. בדיקת התוצאה נעשית מול SQLite המקורי, כך שאפשר להפעיל אותם מבחנים בכל שפה. הבדיקות הותאמו ממערך הבדיקות הקיים של SQLite.
במאמץ חשיבה מרבי, GPT‑6 Astra השיג אחוז הצלחה ממוצע של 87.4% לעומת 26.8% ב-GPT‑5.6 Sol, עם שיפור בכל שפה. ב-COBOL הקפיצה היא מ-10.9% ל-72.1%, ב-Fortran מ-21.4% ל-83.5%, וב-Visual Basic מ-27.5% ל-89.4%. Astra עבר 83% ב-19 מתוך 20 השפות, ו-COBOL נשארה הקשה ביותר.
GPT‑6 Luna, האפשרות הזולה, הגיע ל-40.3% בממוצע. העלות המוערכת שלו היא 0.77 דולר לדגימה לעומת 3.48 דולר ב-GPT‑5.6 Sol, כ-78% פחות.
המבחן השני: העברת COBOL לשפה אחרת
המבחן השני בודק המרה של תוכניות COBOL ל-C++, Java, Kotlin, Python או Rust, תוך שמירה על ההתנהגות המקורית. זה לא עניין קטן. בחשבון של COBOL, ספרות עשרוניות עודפות נחתכות אלא אם ביקשו עיגול מפורש. כתיבה מחדש שמעגלת במקום לחתוך תרוץ בלי שגיאות, אבל תיתן תוצאות כספיות אחרות.
הבדיקות הנסתרות דורשות התאמה מדויקת, בית אחר בית, בפלט הנצפה, וההמרה נחשבת מוצלחת רק אם כל הבדיקות עוברות. GPT‑6.1 Sol השיג 86.6% דיוק במאמץ חשיבה נמוך, לעומת 5.4% ב-GPT‑5.6 Sol, בעלות של 61% ממנה. במאמץ גבוה הדיוק מגיע ל-97.9%, כמעט תקרת המבחן.
מה עדיין לא ברור
OpenAI מזהירה בעצמה שהטמעה בתוכנה אמיתית עדיין דורשת סקירה של מומחים ובדיקה מול החוקים העסקיים והתלויות של המערכת. ההודעה לא מציינת פרסום של מבחן ההמרה של COBOL, ולכן לא ברור אם אפשר לבדוק אותו מבחוץ. את MultiLangBench כן שחררה החברה: היא העלתה ל-GitHub את מערך המבחן ואת התוצאות לכל שפה, כך שמפתחים יכולים לבדוק את הביצועים בשפות שלהם. במאגר מצוין שמומלץ להריץ רק 272 בדיקות מתוך כ-24 אלף שהומרו, בגלל העלות.
מה זה אומר בשבילכם
הנתונים רלוונטיים בעיקר לצוותי פיתוח שמתחזקים או מחדשים מערכות ישנות, למשל בבנקאות ובמדע. OpenAI מזמינה לנסות את המודלים החדשים דרך ה-API על משימות בשפות של הצוות, ומבקשת משוב על שפות וזרימות עבודה לשיפור. ההודעה לא מפרטת מחירים, זמינות בישראל או תמיכה בעברית.
תגובות