RAG, קיצור של Retrieval-Augmented Generation ("יצירה מועשרת באחזור"), היא שיטה שבה מערכת AI שולפת קודם מידע רלוונטי ממאגר ידע, מוסיפה אותו להודעה שנשלחת למודל, ורק אז המודל כותב תשובה. לפי Anthropic, מפתחים משתמשים בה כדי להעשיר את הידע של מודל שפה, למשל בצ'אטבוט שירות שצריך להכיר את העסק הספציפי, או בבוט משפטי שצריך להכיר מקרים קודמים רבים.
איך RAG עובד
דמיינו מבחן עם חומר פתוח. במקום להסתמך רק על מה שהמודל "זוכר" מהאימון, מניחים לידו את הדפים הנכונים לפני שהוא עונה. זו השוואה שלנו להמחשה, ועכשיו לפרטים הטכניים כפי שהם מתוארים ב-הפוסט של Anthropic.
ההכנה נעשית מראש, בשלושה שלבים:
- מחלקים את המסמכים ל"חתיכות" (chunks) קטנות, בדרך כלל לא יותר מכמה מאות טוקנים.
- ממירים כל חתיכה ל-embedding, וקטור מספרים שמקודד את המשמעות שלה.
- שומרים את הווקטורים ב-vector database, מסד נתונים שמאפשר לחפש לפי דמיון במשמעות.
כשמשתמש שואל שאלה, המערכת מחפשת במסד את החתיכות הקרובות ביותר לשאלה במשמעות, ומוסיפה אותן להודעה שנשלחת למודל. המודל מנסח את התשובה על בסיסן.
בתיעוד של OpenAI יש דוגמה לחיפוש כזה, שנקרא semantic search (חיפוש סמנטי). על השאלה "When did we go to the moon?" המשפט "The first lunar landing occurred in July of 1969" קיבל דמיון סמנטי של 65%, אף שאין בו אף מילה משותפת עם השאלה. בדמיון של מילות מפתח הוא קיבל 0%.
מי המציא ולמה
הרעיון מתועד במאמר מחקר שהוגש ל-arXiv ב-22 במאי 2020. המאמר מציין שמודלי שפה גדולים אמנם שומרים ידע עובדתי בפרמטרים שלהם, אבל היכולת שלהם לגשת לידע הזה ולטפל בו בדיוק מוגבלת. גם מתן מקור להחלטות שלהם ועדכון הידע שלהם נשארו בעיות פתוחות.
החוקרים חיברו זיכרון פרמטרי (מודל seq2seq שאומן מראש) עם זיכרון חיצוני: אינדקס וקטורי של ויקיפדיה, שמגיעים אליו דרך מנגנון אחזור. הם בדקו שתי גרסאות. באחת המערכת נשענת על אותן פסקאות לאורך כל הטקסט שנוצר, ובשנייה היא יכולה להשתמש בפסקאות שונות לכל טוקן. לפי המאמר, המודלים קבעו שיא חדש בשלוש משימות של שאלות פתוחות, והטקסט שיצרו היה ספציפי, מגוון ועובדתי יותר ממודל בסיס שמסתמך על הפרמטרים בלבד.
למה משתמשים בו
לפי Google Cloud, מודלי שפה מוגבלים לנתוני האימון שלהם, ולכן תשובותיהם עלולות להיות מיושנות ולא מדויקות. RAG מזין אותם במידע עדכני. כשמספקים למודל עובדות כחלק מההודעה, אפשר גם לצמצם "הזיות", כלומר תשובות שהמודל ממציא. AWS מתארת זאת כך: המודל פונה למקור מידע מוסמך שנמצא מחוץ לנתוני האימון שלו, למשל מסמכים פנימיים, דפי Confluence או דפי SharePoint, לפני שהוא כותב תשובה.
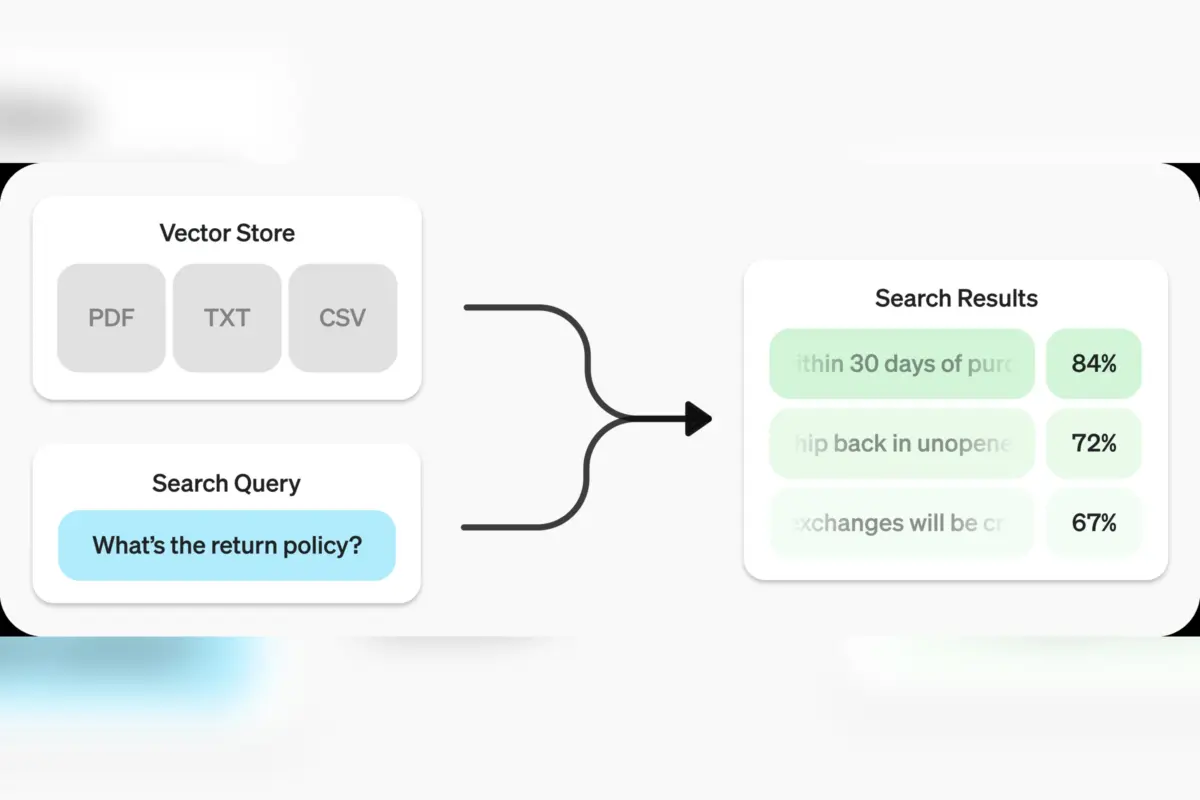
OpenAI מציעה את זה כשירות מוכן: מעלים קבצים ל-vector store, והכלי file search מאחזר מהם מידע וגם מחזיר ציטוטים מהקבצים. לפי עמוד התמחור, נכון לבדיקה שלנו, אחסון של עד 1GB בכל המאגרים חינמי, ומעבר לכך המחיר הוא 0.10 דולר ל-GB ליום.
המגבלות והסיכונים
האיכות תלויה בשלב האחזור. Google מזהירה שאם המידע שנשלף לא רלוונטי, התשובה עשויה להיות מבוססת על מקור אבל לא קשורה לשאלה או שגויה.
Anthropic מצביעה על בעיה נוספת: חלוקה לחתיכות מאבדת הקשר. חתיכה שאומרת "ההכנסות של החברה עלו ב-3% ביחס לרבעון הקודם" לא מציינת על איזו חברה ואיזה רבעון מדובר, ולכן קשה למצוא אותה או להשתמש בה. השיטה Contextual Retrieval מוסיפה לכל חתיכה הסבר קצר (בדרך כלל 50 עד 100 טוקנים) לפני שמקודדים אותה. במבחנים של Anthropic שיעור האחזורים שנכשלו ירד מ-5.7% ל-2.9%, ירידה של 49%. כשמוסיפים שלב של reranking, השיעור ירד ל-1.9%, ירידה של 67%.
ב-התיעוד של Azure AI Search מפורטים אתגרים נוספים:
- הבנת שאלות מורכבות או עמומות.
- גישה למקורות מידע רבים.
- מגבלת הטוקנים של המודל, שמחייבת להחזיר תוצאות קצרות ורלוונטיות.
- זמן תגובה של שניות.
- אבטחה: משתמשים צריכים לקבל רק תוכן שהם מורשים לראות.
ייתכן גם שבכלל אין צורך ב-RAG. לפי Anthropic, אם מאגר הידע קטן מ-200,000 טוקנים (כ-500 עמודים), אפשר לצרף אותו כולו להודעה. עם prompt caching זה מהיר וזול יותר.
מונחים קשורים
- Embedding: ייצוג מספרי של טקסט שמקודד את המשמעות שלו.
- Vector database: מסד נתונים שמחפש לפי דמיון בין וקטורים.
- BM25: שיטת דירוג ותיקה שמחפשת התאמה מדויקת של מילים וביטויים. היא יעילה למזהים ייחודיים. למשל, בחיפוש "Error code TS-999" היא תמצא את הטקסט המדויק, ואילו חיפוש סמנטי עלול לפספס אותו.
- Hybrid search: חיפוש שמשלב חיפוש סמנטי וחיפוש לפי מילות מפתח.
- Reranking: שלב סינון שנותן לכל חתיכה ציון רלוונטיות ומעביר למודל רק את הטובות ביותר. הוא מוסיף מעט זמן המתנה.
- Grounding: ביסוס התשובה על עובדות שסופקו למודל.
- Agentic retrieval: גישה ב-Azure AI Search שבה מודל שפה מפרק שאלה מורכבת לכמה תת-שאלות ומריץ אותן במקביל. בתיעוד היא מסומנת כ-preview.
שאלות נפוצות
האם RAG מונע הזיות לגמרי?
לא. לפי Google, מתן עובדות למודל יכול לצמצם הזיות, ולא להעלים אותן. אם האחזור מחזיר מידע לא רלוונטי, התשובה עלולה להיות שגויה.
מה ההבדל בין חיפוש רגיל לחיפוש סמנטי?
חיפוש לפי מילות מפתח מחפש מילים משותפות. חיפוש סמנטי משתמש ב-embeddings ויכול למצוא תוצאה רלוונטית גם כשכמעט אין בה מילים משותפות עם השאלה.
האם חייבים RAG כדי לתת למודל מסמכים משלנו?
לא תמיד. מאגר קטן מ-200,000 טוקנים אפשר לצרף ישירות להודעה. RAG מתאים למאגרים גדולים יותר, שלא נכנסים בחלון ההקשר של המודל.
איך מגנים על מידע פרטי?
לפי Azure, צריך בקרת גישה מפורטת, כך שמשתמשים וסוכנים יקבלו רק תוכן שהם מורשים לראות. הכלים שלה יורשים הרשאות מ-SharePoint ומ-Microsoft Entra ID.
להעמקה אפשר לקרוא את הסבר Google Cloud ואת מדריך ה-Retrieval של OpenAI.
תגובות