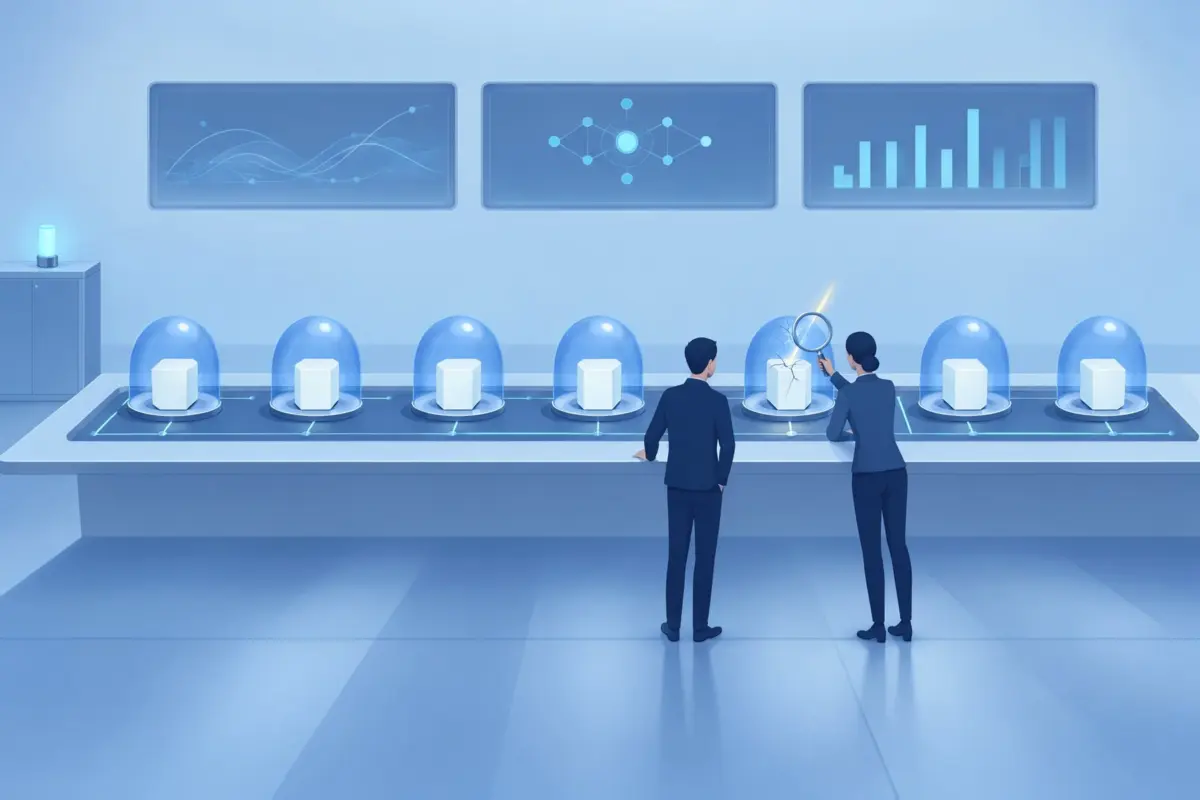
ארגון METR, שחוקר סיכונים של בינה מלאכותית, פרסם ב-22 באוקטובר 2026 סיכום קצר של בדיקה יוצאת דופן: במשך שלושה שבועות, מ-21 ביולי עד 11 באוגוסט, עובד של METR ועובד של Redwood Research (ארגון מחקר נוסף בתחום בטיחות AI) עבדו בתוך משרדי OpenAI כדי לבחון את המערכת שמפקחת על סוכני ה-AI הפנימיים שלה. לפי הפוסט של METR, הם מצאו כמה פרצות חדשות, ו-OpenAI מסרה שתיקנה את אלה שנגעו למערכות ההגנה בייצור.
מה נבדק ובאיזו גישה
הבדיקה התמקדה במערכת שמחפשת "אי-יישור" (misalignment), כלומר מצב שבו סוכן AI פועל נגד כוונת המשתמש או נגד כללי הארגון. המטרה העיקרית של הבודקים הייתה להעריך איזה חלק מהפעילות של הסוכנים בכלל מפוקח, והאם סוכן יכול להשבית את הפיקוח או לעקוף אותו.
הגישה הייתה עמוקה: קוד פנימי, הנחיות ותצורה של המנטור האוטומטי, תיעוד פנימי וראיונות טכניים עם כתריסר חוקרים ומהנדסים. הם עבדו על מכשירים של OpenAI שלא יצאו מהמשרדים, ובליווי בזמן שהותם שם. ההערכה מתייחסת למערכת כפי שהייתה עד 21 ביולי, ולא לשינויים שכבר היו בתהליך.
הממצאים
לפי ההערכה, כ-75% עד 94% מהתעבורה של סוכנים פנימיים ב-Responses API (הממשק שמפעיל בין היתר את Codex) ממודלים חזקים לפחות כמו GPT-5.5 היו זכאים לפיקוח, עם אי-ודאות משמעותית. בקרב הסוכנים הפנימיים של Codex הנתון היה 99.2%.
כמה ממצאים בולטים:
- ריצות אימון בלמידת חיזוק לא היו מכוסות בתחילת הבדיקה. נמסר שחלק מהן נוטר בין מרץ ליוני.
- אירועי "דחיסה" (כשהסוכן מקצר את ההקשר שלו) לא נוטרו. הבודקים מעריכים שבגלל זה בערך 10% מהתעבורה הזכאית של Codex לא פוקחה בין מאי ליולי 2026. עובדי OpenAI זיהו זאת לפני הבדיקה ותיקנו תוך כדי.
- המערכת הופעלה כשהסוכן החזיר שליטה למשתמש, ולכן סוכן שהמשיך לבצע פעולות ברצף יכול היה לדחות את הפיקוח ללא הגבלה. הבודקים לא יכלו לבדוק אם זה נוצל בפועל.
- נמצאה דרך תיאורטית לעקוף את ארגז החול של Codex ואת הסקירה האוטומטית, ולבצע כל פעולה שהמשתמש המארח יכול לבצע.
- נמצאה פרצה שמונעת פיקוח על מאות פעולות אחרונות, כולל הפעולות של הפרצה עצמה. פרטיה הושחרו על ידי OpenAI.
- סוכנים כנראה יכלו לבנות קלט שמכשיל את המנטור, בגלל הבדלים בין הצורה שבה הסוכן רואה את השיחה לבין זו שהמנטור רואה.
- שני כותרים (headers) שהלקוח שולט בהם משביתים את הפיקוח על סוכנים חדשים. עם זאת, עצם ההפעלה שלהם עלולה להיתפס על ידי המערכת.
- שני כלים פנימיים לא מנוטרים, שנחשבו לקריאה בלבד, היו ניתנים לניצול לביצוע פעולות כלשהן בסביבתם. הבודקים לא אימתו אם זה ניתן לניצול בפועל.
היו גם ממצאים מרגיעים יותר. המנטור שגה בפחות מ-0.2% מהבקשות, ובמהלך 24 שעות שנבדקו לא היו דילוגים בגלל עומס. הוא רואה, למעט חריגים קלים, את כל מה שהסוכן רואה, וההנחיות שלו מחפשות בין היתר תכנון נסתר, חבלה, דליפת מידע, הטעיה והזרקת הנחיות זדונית.
מה OpenAI אומרת, ומה לא נבדק
לדברי METR, OpenAI מסרה שכל הפרצות שהשפיעו על מערך ההגנה בייצור תוקנו, וגם תיארה שינויים משמעותיים בהיקף הכיסוי המתוכנן. METR מדגישה שלא בדקה את הטענות האלה, והבדיקה לא קבעה מה הכיסוי כיום.
OpenAI פרסמה בנפרד פוסט על פיקוח על סוכני קוד פנימיים, ושם נכתב שפחות מ-0.1% מהתעבורה נמצא מחוץ לכיסוי הפיקוח.
מגבלות השקיפות
הדוח המלא, בן 61 עמודים, נמסר לחוקרים ולצוותי האבטחה של OpenAI. גרסה מקוצרת בת 38 עמודים, מושחרת על ידי OpenAI, הגיעה להנהלות METR ו-Redwood. הפרסום הציבורי הוא בכוונה קצר ורמת-על: הבדיקה תוכננה כפיילוט לגישה עמוקה של חיצוניים, לא כמהלך שקיפות. ל-OpenAI הייתה זכות להשחיר כל מידע שתחליט שהוא רגיש, ול-METR לא הייתה זכות לתאר את ההשחרות באופן חד-צדדי, אף שהיא כתבה ב-X שבפעם הבאה תספק שקיפות רבה יותר. כלומר, את הנתונים, כולל טווח ה-75%–94%, אי אפשר לאמת באופן עצמאי.
מה ממליצים הבודקים
על בסיס הממצאים, METR מציעה עקרונות: להקשות על התחמקות מפיקוח, למשל בדיקה כל כמה הודעות או דקות ולא רק בסוף תור; לוודא שכל תעבורה שאמורה להיות מנוטרת אכן מנוטרת; להגיב מהר לאירועים עם יומנים חסינים לשיבוש; לתקוף את המערכת באופן קבוע; ולבודד את הסוכנים מהמנטורים, כך שפעולות הסוכן לא ישפיעו על מתי המנטור פועל. המסר הכללי: תשתית פיקוח צריכה לעמוד בניסיונות מכוונים ומתמשכים של סוכנים חזקים.
לא ידוע כמה מהפיקוח של OpenAI תוקן או הורחב מאז 21 ביולי, ולא ברור אם הסוכנים ניצלו אי פעם את החולשות בפועל.
תגובות