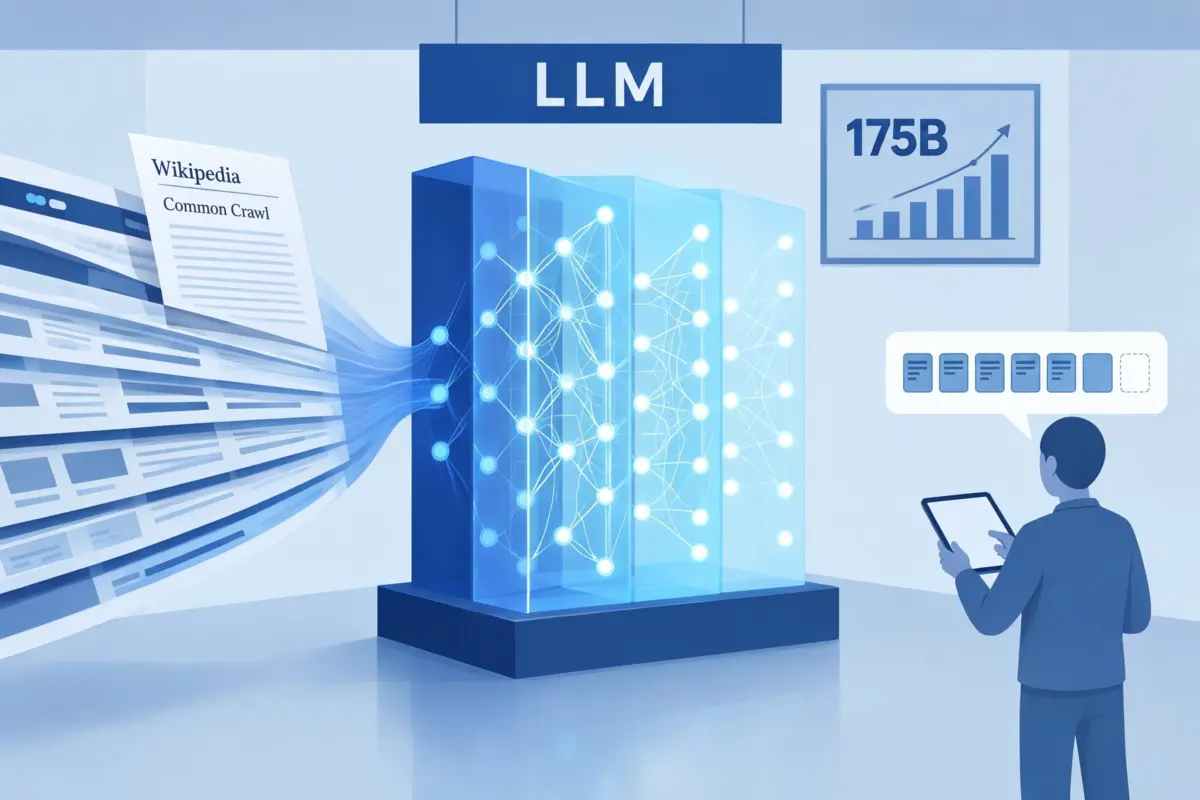
LLM, קיצור של Large Language Model (מודל שפה גדול), הוא מודל למידה עמוקה גדול מאוד שאומן מראש על כמויות עצומות של נתונים. לפי הגדרת Google Cloud, זהו מודל סטטיסטי שאפשר להשתמש בו כדי ליצור ולתרגם טקסט ותוכן אחר, ולבצע משימות נוספות של עיבוד שפה טבעית. אנשים מדברים עליו כי הוא המנוע שמאחורי צ'אטבוטים ועוזרים דיגיטליים, ומודל אחד יכול לענות על שאלות, לסכם מסמכים, לתרגם ולהשלים משפטים.
איך זה עובד
לפי AWS, מודל שפה גדול לומד מטקסט רב, לעיתים מהאינטרנט. מקורות לדוגמה הם Common Crawl, שכולל יותר מ-50 מיליארד דפי אינטרנט, וויקיפדיה, עם כ-57 מיליון דפים. בזמן האימון המודל מכוון שוב ושוב את הפרמטרים שלו, עד שהוא מצליח לנבא נכון את ה-token הבא (יחידת טקסט קטנה, בערך חלק ממילה) מתוך רצף ה-tokens שקדם לו.
הפרמטרים הם המשקלות וההטיות (weights ו-biases) של הרשת העצבית, יחד עם ה-embeddings. ברשתות גדולות יש מיליארדים רבים מהם. כדי שהמודל יבין שמילים קרובות במשמעותן, הוא מייצג כל מילה כוקטור רב-ממדי (word embedding), כך שמילים עם הקשר דומה נמצאות קרוב זו לזו במרחב הווקטורי.
מי המציא את הארכיטקטורה ומתי
הבסיס לרוב המודלים האלה הוא ה-Transformer. Google מציינת שפיתחה אותו ב-2017, והוא תואר במאמר "Attention Is All You Need" שפורסם ב-arXiv ביוני 2017. קודם לכן שלטו רשתות רקורסיביות וקונבולוציה. המאמר הציע ארכיטקטורה שמבוססת רק על מנגנוני attention (קשב), בלי רקורסיה ובלי קונבולוציה. במשימות תרגום היא השיגה תוצאות טובות יותר, התאמנה מהר יותר וניתנה להרצה מקבילית. למשל, בתרגום מאנגלית לצרפתית הושג ציון BLEU של 41.8 אחרי 3.5 ימי אימון על שמונה מעבדי GPU.
לפי AWS, ה-Transformer מורכב מקודד ומפענח עם יכולת self-attention. בניגוד לרשתות הישנות, הוא מעבד רצפים שלמים במקביל, ולכן אפשר לאמן אותו על GPU ולקצר משמעותית את זמן האימון.
צעד חשוב נוסף היה GPT-3 של OpenAI, שתואר במאמר "Language Models are Few-Shot Learners" ב-2020. זה מודל עם 175 מיליארד פרמטרים, פי 10 מכל מודל לא דליל קודם. החוקרים הראו שהגדלת המודל משפרת מאוד את הביצועים גם כשנותנים לו רק כמה דוגמאות.
למה משתמשים בו
לפי המקורות, השימושים כוללים:
- כתיבת טקסטים שיווקיים ויצירת תוכן, למשל סיפור קצר לילדים.
- מענה על שאלות מתוך מאגרי מידע.
- סיווג טקסטים, למשל מדידת תחושות לקוחות וחיפוש במסמכים.
- כתיבת קוד מהנחיות בשפה טבעית, כולל שאילתות SQL ופקודות shell.
- סיכום מסמכים מורכבים, כמו מאמרי מחקר ודוחות כספיים.
מודלים יכולים להתאמן גם על קוד, תמונות, שמע ווידאו. Google מציינת את Gemini כמודל רב-מודלי, כלומר כזה שמבין סוגי קלט שונים. משפחת Claude של Anthropic היא עוד דוגמה: לפי התיעוד, כל המודלים הנוכחיים בה תומכים בקלט של טקסט ותמונה ובפלט טקסט. חלון ההקשר שלהם, כלומר כמות הטקסט שאפשר להכניס בבת אחת, הוא מיליון tokens, שהם בערך 555 אלף מילים.
המגבלות
AWS כותבת במפורש שהמודלים אינם מושלמים ואינם חפים מטעויות, ושדיוק התשובות משתנה. גם מאמר GPT-3 מזהה מערכי נתונים שבהם המודל עדיין מתקשה, ובעיות מתודולוגיות הקשורות לאימון על מאגרי אינטרנט גדולים. החוקרים מצאו גם שבני אדם התקשו להבדיל בין כתבות חדשות שנוצרו במודל לכתבות שכתבו אנשים, ולכן דנו בהשלכות החברתיות של זה.
מונחים קרובים
- Fine-tuning (כוונון עדין): אימון נוסף של מודל קיים על נתונים שמתאימים ליישום מסוים.
- Zero-shot ו-few-shot: בראשון המודל עונה בלי דוגמאות. בשני נותנים לו כמה דוגמאות רלוונטיות, והביצועים משתפרים.
- Prompt (הנחיה): הטקסט שמזינים למודל כדי לקבל ממנו תשובה.
- Generative AI (בינה מלאכותית יוצרת): שימוש במודלים כאלה ליצירת תוכן חדש מתוך הנחיה.
שאלות נפוצות
האם LLM ו-ChatGPT זה אותו דבר?
לא. LLM הוא סוג המודל. לפי AWS, ChatGPT הוא "בן דוד" של GPT-3 של OpenAI. מודלים אחרים כוללים את Claude, Llama 2 ו-Gemini.
למה קוראים לו "גדול"?
בגלל מספר הפרמטרים, שיכול להגיע למאות מיליארדים, ובגלל כמות הנתונים שעליהם הוא מאומן.
האם צריך לאמן אותו מחדש לכל משימה?
לא בהכרח. מודל אחד מסוגל לבצע משימות שונות, ואפשר לשפר אותו למשימה מסוימת באמצעות דוגמאות או כוונון עדין.
איפה קוראים עוד?
אפשר לעיין בהסבר של AWS, בעמוד של Google Cloud, במאמר על ה-Transformer או בתיעוד של מודלי Claude.
תגובות