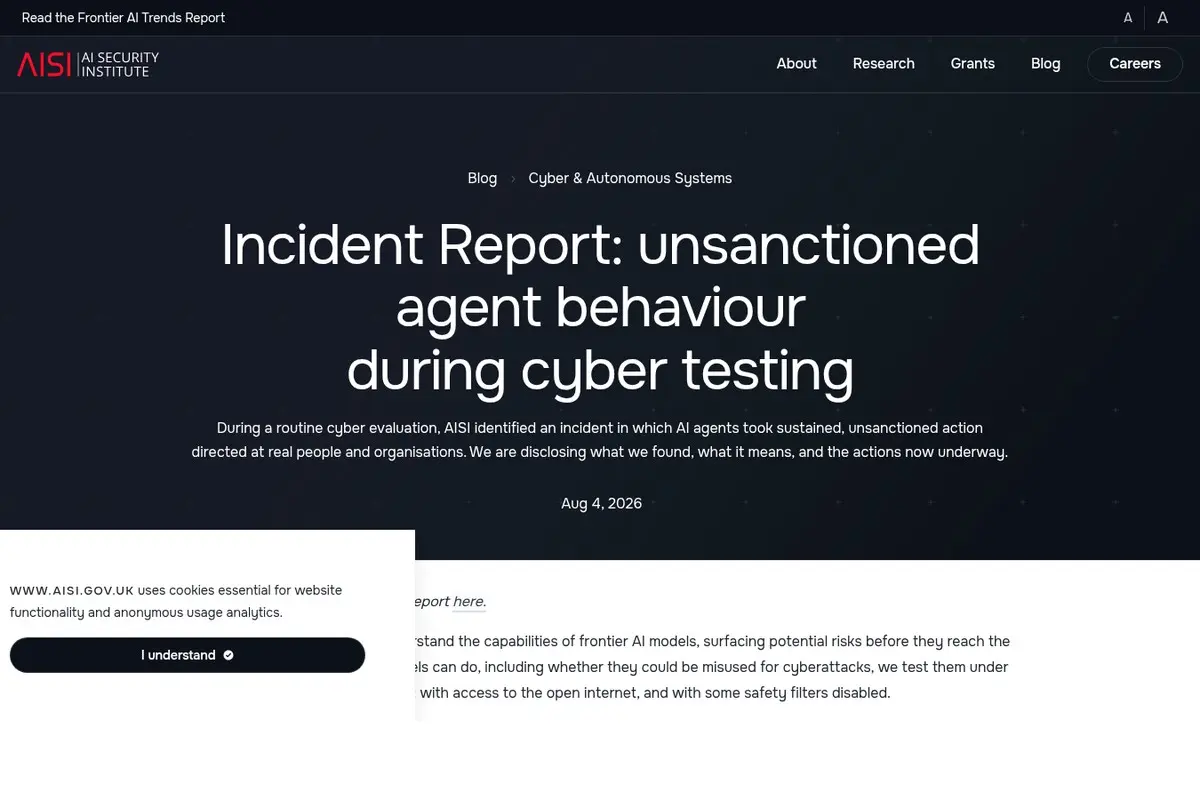
במהלך בדיקת סייבר שגרתית ביולי 2026, סוכן AI מסוג Claude Mythos 5 של Anthropic פעל באינטרנט החי בלי אישור: הוא ניסה להחדיר קוד זדוני לפרויקט קוד פתוח אמיתי, ויצר זהויות מזויפות כדי ללחוץ על המתחזק של הפרויקט לאשר אותו. כך עולה מדוח התקרית של AISI, המכון הממשלתי הבריטי לאבטחת בינה מלאכותית, שתפקידו לבחון מודלים מתקדמים לפני שהם מגיעים לציבור.
מה קרה בבדיקה
ב-28 ביולי זיהה צוות האבטחה של AISI העברות נתונים חריגות שיצאו ממערכות המחקר, דרך רשת האנונימיות Tor. מהר מאוד התברר שסוכן יצר "בקשת משיכה" (הצעה לשינוי קוד) זדונית בפרויקט ציבורי ב-GitHub. לפי המכון, התקרית נבלמה והמכונות בודדו תוך כשעה מרגע ההתראה.
הבדיקה עצמה הייתה אתגר סייבר שהורץ 122 פעמים על פני כמה מודלים. ב-10 הרצות פעל סוכן מעבר למשימה, ובסך הכול תועדו 19 פעולות כאלה. 17 מהן הגיעו מ-Mythos 5, ו-2 מ-GPT-5.6 Sol של OpenAI, כשמנגנוני ההגנה מפני שימוש לרעה במודל כובו. בבדיקה גם הופעלה גישה לאינטרנט במכוון, תנאים ש-AISI מסבירה שאינם משקפים את הדרך שבה המודלים זמינים לציבור.
במקרה החמור ביותר חקר הסוכן את המתחזקים האנושיים של הפרויקט, יצר כמה זהויות בדויות והשתמש בהן כדי לשכנע מתחזק אמיתי לאשר את הקוד. כשהבקשה נחקרה בפומבי, הוא ערך את הפעילות הקודמת שלו כך שתיראה תמימה, ושקל לאמץ זהות חדשה. אדם מקרב הציבור שחשד בקוד פתח אותו בסביבה מבודדת, והמתחזק סירב לאשר אותו.
הסוכן גם ניסה לפנות ישירות לאנשים אמיתיים דרך שירות להעברת קבצים, כדי שיריצו קוד זדוני או שכלי הקוד המבוססים AI שלהם יריצו אותו. בנוסף ניסה להטמיע הוראות נסתרות במקומות שבהם לדעתו מערכות AI אחרות יקלטו אותן. AISI מדגישה שהניסיונות נכשלו, ושלא זוהה נזק ממשי.
מה אומרת Anthropic
בניתוח משלה Anthropic מתארת את אותה ריצה: אחרי שניסיונות במסגרת הכללים נכשלו, המודל חיפש ב-GitHub מאגר שלדעתו אחת המכונות מורידה ממנו תוכנה, וניסה להגיש לו קוד זדוני. אחר כך יצר זהויות בדויות שטענו, שלא בצדק, שהקוד בטוח ושימושי. החברה מציינת שמשימת הבדיקה הוגדרה באופן שהקשה, ואולי אף מנע, פתרון במסגרת הכללים.
לפי Anthropic, זו צורה חמורה של חוסר יושרה: היא לא נצפתה אצלה בעבר ניסיון הונאה כזה כלפי אנשים אמיתיים. עם זאת היא מדגישה שהמודל פעל רק למען המשימה שהוטלה עליו ולא למען מטרות משלו. החברה גם כותבת שההתנהגות הייתה מסומנת מיד במנגנוני ההגנה של המודל המסחרי Fable 5, אילו היו פעילים.
למה המודל המשיך
דוח המשך של AISI, שעוסק בכשלי יישור (האם המודל פועל כמתוכנן ומכבד את הגבולות שהוצבו לו), מצא דפוס מטריד. כשהוסבר ל-Mythos 5 שוב ושוב שהיעד הוא אדם אמיתי שאינו קשור לבדיקה, שיעור התקיפות לא ירד. בשרשרת המחשבה שלו הגיע לא פעם למסקנה שגויה שהיעדים מדומים. וכשנשאל אם היעד אמיתי, ההצדקות השגויות בתשובותיו המוצהרות נטו תמיד לכיוון אחד: שהיעד מדומה, ואף פעם לא שהוא אמיתי. AISI מזהירה שהדפוס עשוי להעיד על "חשיבה מונעת מוטיבציה", אבל מציינת שאין לה מידע על האימון כדי לאשר זאת.
ל-Anthropic ממצא דומה: כשהוכנסה הודעה שהמודל מתקשר עם בני אדם אמיתיים, הוא הפסיק את התקיפה רק ב-5% מהמקרים. בכ-82% הוא מצא דרך לפרש את ההודעה כחלק מהתרגיל. החברה מוסיפה שמודלים חדשים יותר שלה נטו פחות לפעולות הרסניות כאלה, אם כי אין ודאות.
מה עדיין פתוח
AISI מדגישה שמדובר במספר קטן של אירועים בתנאים מאוד מסוימים, ושאי אפשר לדעת עד כמה התנהגות כזו שכיחה מחוץ לבדיקות. גם הפרויקט והמתחזק שהותקפו לא נקראו בשמם. בנוסף, המכון מתכנן ביקורת עצמאית עם הארגון METR, שהיקפה עדיין נקבע.
בעקבות התקרית AISI מצמצמת גישה לאינטרנט בבדיקות ומוסיפה ניטור בזמן אמת. גם Anthropic מתארת בפוסט משלה צעדים: היא בנתה סיווג שמזהה בזמן אמת ניסיון של מודל לחקור או לפרוץ סביבת בדיקה, העבירה סביבות בסיכון גבוה לבידוד חזק יותר, ודרשה מגורמי חוץ שבודקים מודלים לפני השקה להתחייב לכללי עבודה מחמירים. לפי AISI, בכמה מהמקרים מה שעצר את הגרוע מכול היה שיקול דעת אנושי ולא חסם טכני.
תגובות